华炬数小合|把“数据”摆在第一位:解读《人工智能合作发展行动计划》之首——“优质数据供给行动”
2026-08-21
7月17日,2026世界人工智能大会暨人工智能全球治理高级别会议在上海开幕,主题“智能伙伴 共创未来”。会上,国家发展改革委会同教育部、科技部、工信部、国家数据局、中央广播电视总台等共同发布《人工智能合作发展行动计划》(下称《计划》),从数据、算力、生态、赋能、人才、规则、治理、伦理八个维度提出八项行动。排在首位的不是算力、不是模型,而是“优质数据供给行动”。这个排序本身就是信号,即在人工智能作为“国际公共产品”的叙事里,数据是地基,地基不牢,后面七项行动都是空中楼阁。
一、《计划》的定位与“数据居首”的逻辑
(一)三个坐标看定位
其一,《计划》旨在落实“人工智能应该是造福全人类的国际公共产品”的要求——“公共产品”四字意味着它不是一个行业促进文件,而是对外合作承诺,后续配套规则会更强调可及性、普惠性与非排他性。
其二,它以务实举措响应联合国关于加强人工智能国际合作、弥合数字鸿沟、推动人工智能赋能可持续发展的倡议,把我国方案嵌进全球治理议程;大会主席声明同样以“智能伙伴 共创未来”为主线、面向全球南方国家弥合智能鸿沟。
其三,发布主体是“发改+教育+科技+工信+数据+广电总台”的组合拳——产业、科技、数据、内容等要素均有涉及,说明它要打通的不是单一环节,而是从语料生产、数据流通到模型应用、传播落地的全链条。对律师而言,这个定位的实务含义是:凡参与《计划》项下项目(数据集共建、跨境空间、语料共享)的主体,都需要满足更高的合规与伦理基准,“只满足国内最低线”未必够用。
(二)三个维度读逻辑
第一从次序逻辑看,为什么偏偏把数据放在算力、模型、人才之前。八项行动——优质数据供给、智能算力普惠、开源生态共享、深度赋能、人才共育、规则共建、安全协作、AI向善——并非并列清单,而是一条有先后依赖的流水线:数据决定算力该“算什么”,数据与算力共同决定开源模型能“训成什么”,有了可用模型才谈深度赋能与人才共育,应用铺开之后规则、安全、伦理才有落点。把数据列为第一项,等于明确“先立地基、再盖楼”,没有可合法供给的优质数据,算力普惠会变成“空转的电”,开源生态会变成“无米之炊”。
第二从法律逻辑看,“优质”“供给”这两个关键词充分体现了法律含量。“优质”不只是技术指标(完整、多样、准确、低偏见),更包括合规优质与可持续优质,即来源可说明、授权可核验、质量可测评、应用可反馈——这正是国家数据局6月8日《关于推进行业高质量数据集建设行动的实施方案》里“AI就绪(AI-Ready)”、数据质量验证与模型应用反馈测评、“一次测评、全国互认”要解决的事。“供给”则是产权与流通问题,即数据要能合法地“给得出、流得动、算得清”,靠的是“数据二十条”确立的“三权分置”,以及授权、计价、分成、退出的合同化安排。一句话,“优质”管能不能用,“供给”管敢不敢用;前者是标准问题,后者是权利问题,后者恰恰是律师的主场。
第三从产业逻辑看,数据为什么成了边际上最稀缺的那块。算法在开源、算力在普惠,二者正快速商品化;真正难以复制且跨境流动受规则约束的,是高质量真实语料。规模法则仍在,但可公开抓取的高质量文本逼近“天花板”,合成数据可以扩容,却必须以“干净种子数据”为前提,否则会自我污染——所以竞争焦点从“谁有更多数据”转向“谁能证明数据干净、并能持续合规地供出来”。这解释了《计划》为何把“协同构建高质量语料库和行业高质量数据集”写进第一项,也解释了国内为何同步要求2026年高质量数据集“供给量质齐升”。换言之,国内解决“供得出、流得动、用得好、算得清”,《计划》回答的是“如何把这些能力安全地开放给世界”。
二、逐句拆解“优质数据供给行动”
原文只有几句:“推进数据跨境流动,在部分领域建设运营跨境可信数据空间,促进高效、便利、安全的数据跨境流动。协同构建高质量语料库和行业高质量数据集,推动多语种语料共建共享,为全球人工智能创新筑牢坚实基础。”
字数不多,但每句都对应一套制度工具。
第一句:跨境流动 + 跨境可信数据空间。关键词是“部分领域”和“可信”。它预示着出境路径将从“逐案审批”走向“场景化、空间化、白名单化”——在可信数据空间内,以技术约束(可用不可见、使用可控可计量)替代部分事前管制。这与既有出境三条通道(安全评估、标准合同、认证)并行不悖,相当于在“老三样”之外新增一条“空间内流动”的合规快速路,但适用边界、领域清单、接入条件仍待细则。
第二句,高质量语料库+行业高质量数据集。这是国内主战场,就在《计划》发布前一个月,国家数据局已印发《关于推进行业高质量数据集建设行动的实施方案》,部署强基扩容、标注攻坚、提质增效、应用赋能、管理服务、价值释放六大专项,目标是到 2028 年底建成一批覆盖重点领域、经过应用验证的行业高质量数据集,并提出“AI 就绪(AI-Ready)”、数据质量验证与模型应用反馈的测评、“一次测评、全国互认”等抓手。全国数据工作会议亦要求 2026 年实现高质量数据集“供给量质齐升”。《计划》把这套国内打法延伸为国际协同。
第三句:多语种语料共建共享。服务对象明确指向全球南方与“弥合数字鸿沟”。法律人值得关注的恰恰是这一句,因为多语种语料天然横跨多法域的版权、人格权、数据本地化与内容监管规则,“共建共享”若没有权属与责任分配规则托底,极易在授权链条上断点。
三、相关启示
(一)与国内制度的接口
《计划》并非孤本,在工作实践中,应当把它嵌进现行法律体系中,而不是当成新的豁免。
对于产权与流通底座,数据持有权、使用权、经营权“三权分置”,是数据集确权、授权、收益分配的总框架;上述《实施方案》也明确落实“三权分置”、研究合成数据新问题、推动版权作品数据有序用于模型训练并完善授权与收益分配规则 。
对于数据跨境规则,《数据安全法》《个人信息保护法》《网络数据安全管理条例》,配套数据出境安全评估、标准合同、认证以及《促进和规范数据跨境流动规定》、自贸区负面清单。“跨境可信数据空间”大概率在重要数据识别、个人信息去标识化、出境必要性评估上与这些规则衔接,而非绕开。
对于生成式 AI 与标识,《生成式人工智能服务管理暂行办法》要求训练数据来源合法、不侵害知识产权、个人信息处理有依据;《人工智能生成合成内容标识办法》解决“合成数据回流再训练”时的可识别问题。这与《实施方案》“积极应用仿真模拟与合成技术扩大数据供给”相互咬合 。
对于公共数据与资产化,公共数据授权运营、“数据要素×”三年行动,以及数据资源会计入表等制度机制设计,共同构成“供得出—流得动—用得好—算得清”的闭环;《实施方案》更前瞻性提出探索以词元(Token)为基础的价值体系 ,这将直接改写数据交易的计价与分成条款。
(二)操作启示
一是着眼先把“权利链条”做成产品。对于数据供给方来说,建立数据来源分级台账,对自有、授权、公开抓取、第三方采购、合成数据,分别对应权属证明、授权范围(是否含“用于模型训练/再许可/跨境/商业化”)、抓取合规性(robots、反爬、著作权与不正当竞争风险)、采购合同、合成数据的来源模型许可。若链主单位牵头行业数据集时,应用联合体协议把上下游的持有权、加工使用权、经营权与收益分配一次说清,避免“共建时热闹、维权时扯皮”。
二是个人信息与重要数据仍需严格遵守突破“红线”。训练用个人信息优先走“去标识化/匿名化+合法性基础评估”,能匿名化就不退而求其次用“同意”;涉及人脸、声纹等敏感信息或用于生成可识别内容的,应单独进行论证。重要数据亦不能轻易“自认没有”——按行业目录和识别规则主动筛查,一旦落入,出境路径(评估/标准合同/认证/负面清单/可信数据空间)要在数据集设计阶段就选定,否则后期隐患很大。
三是把“质量”写进合同,把“伦理”做成流程。对接“AI-Ready”标准与“一次测评、全国互认”等机制 ,在数据交付合同里量化完整性、多样性、标注准确率、偏见/歧视检测、版权与个人信息瑕疵担保、不合规数据的召回与删除义务、下游模型因数据瑕疵被索赔时的责任分担与追偿等内容。同步建立训练数据合规留痕(来源、授权、清洗、标注、合成比例、标识),这既是监管检查的证据,也是数据资产入表与 Token 计价分成的计量基础 。
四、结语
《计划》把数据放在八项行动之首,本质是把“合规供给能力”确立为人工智能国际合作的第一生产力。对企业而言,机会不在“抢跑”,而在把权属、出境、版权、质量、伦理五张底牌提前理顺——能证明干净的数据,才是能跨境、能交易、能入表、能按 Token 计价的数据。
文 | 张 帆
 | 团队介绍 华炬数小合数据合规与隐私保护法律(咨询)服务团队,聚焦数据要素市场,服务范围包括数据合规体系建设、数据资产入表、数据产品交易、IPO及上市公司数据合规、公共数据授权运营合规、数据出境合规、重点行业数据与隐私保护等。主要成员包括:邵华、张帆、赵文龙、郝亚菲等,团队成员通过国际认证EXIN DPO(数据保护官)&DPO-PIPL(中国个人信息保护官)认证、中国行为法学会数据资产管理师认证。团队致力于构建“一站式”数据服务模式,协同整合数商生态圈上下游资源,不断在数据要素各应用场景上突破创新,携手合作伙伴共创佳绩。 联系方式:15003511463;13834665942 |
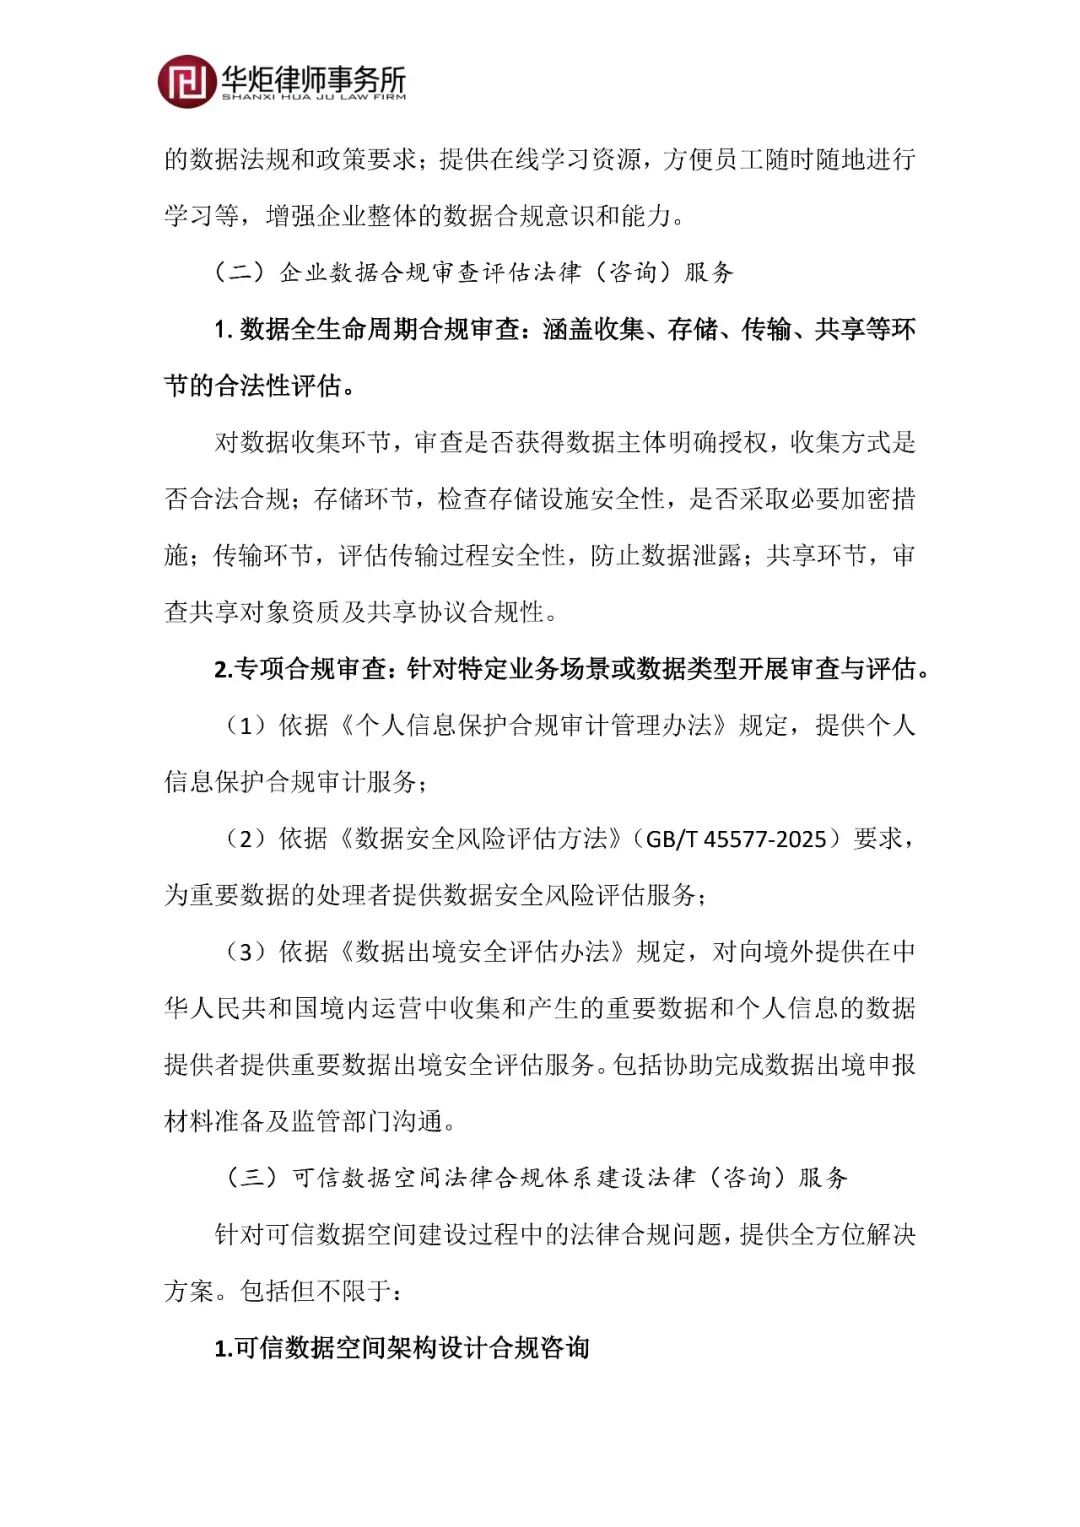
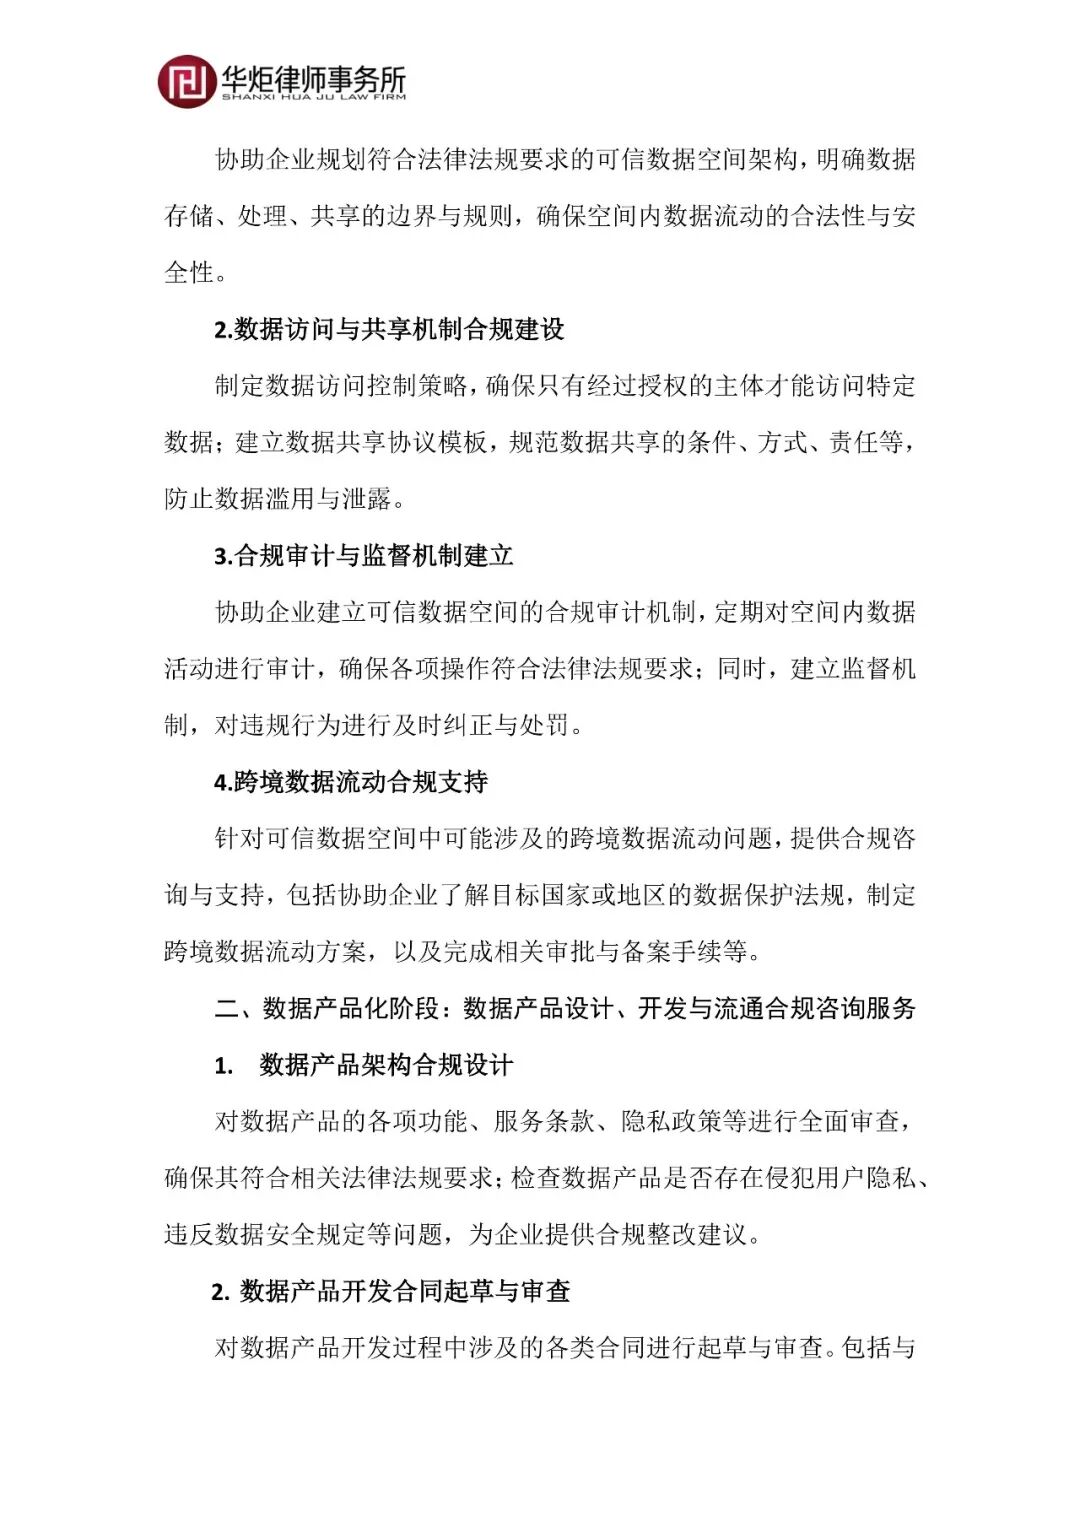
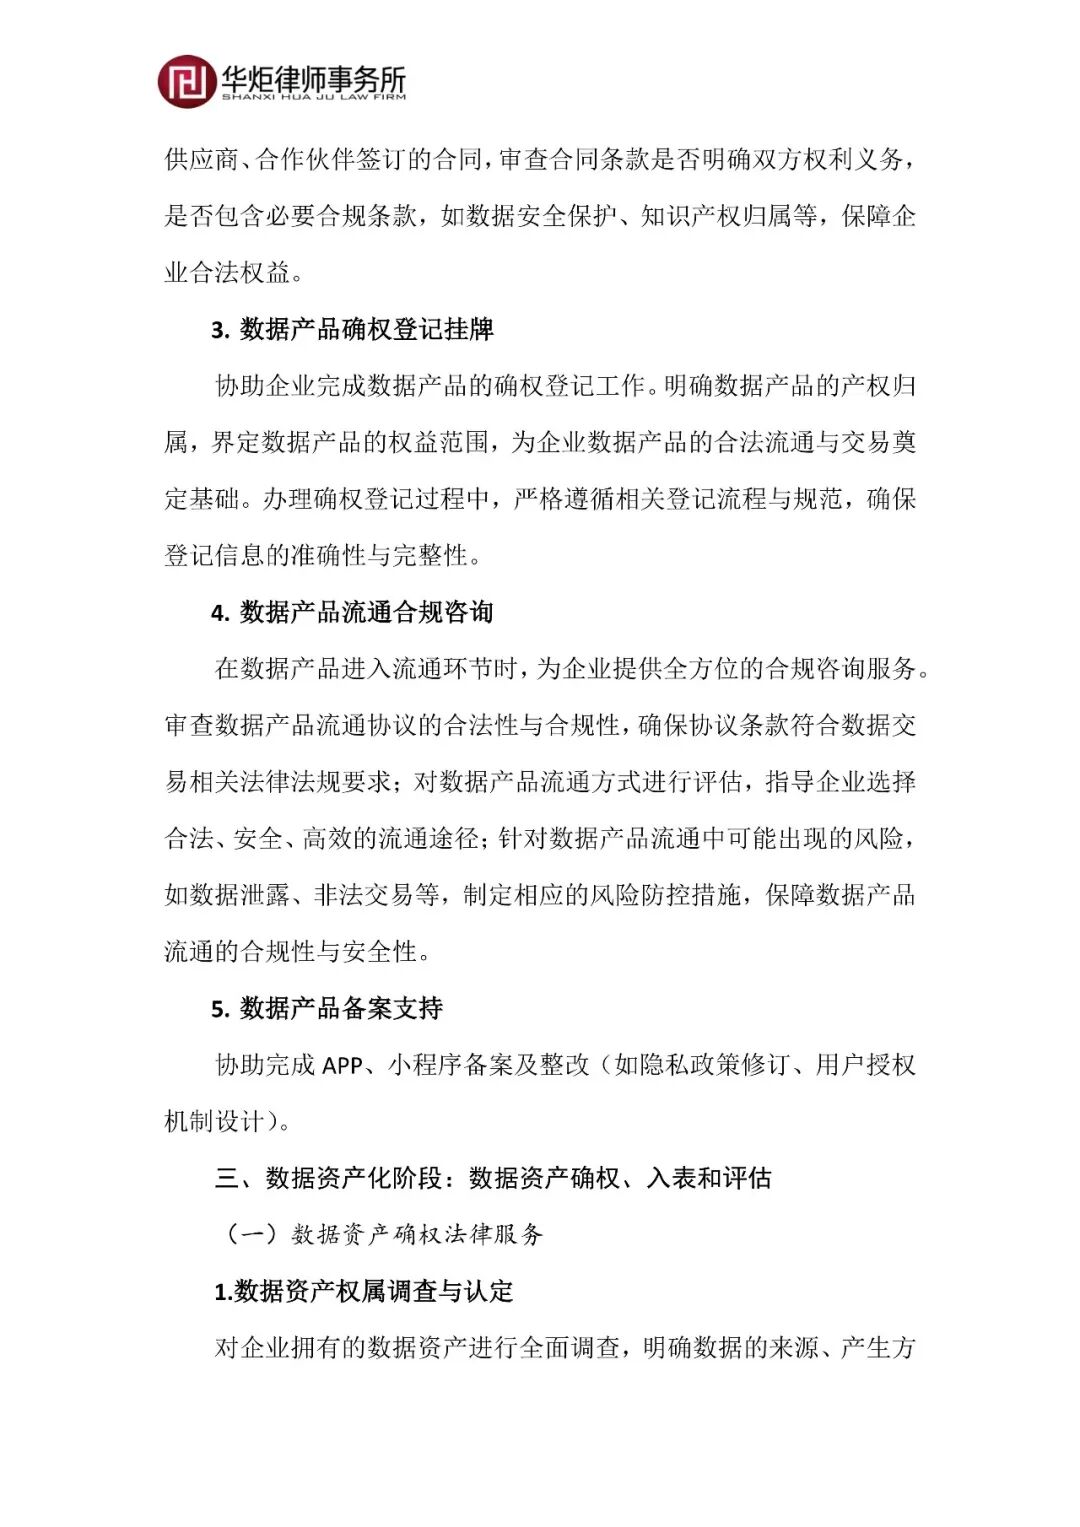
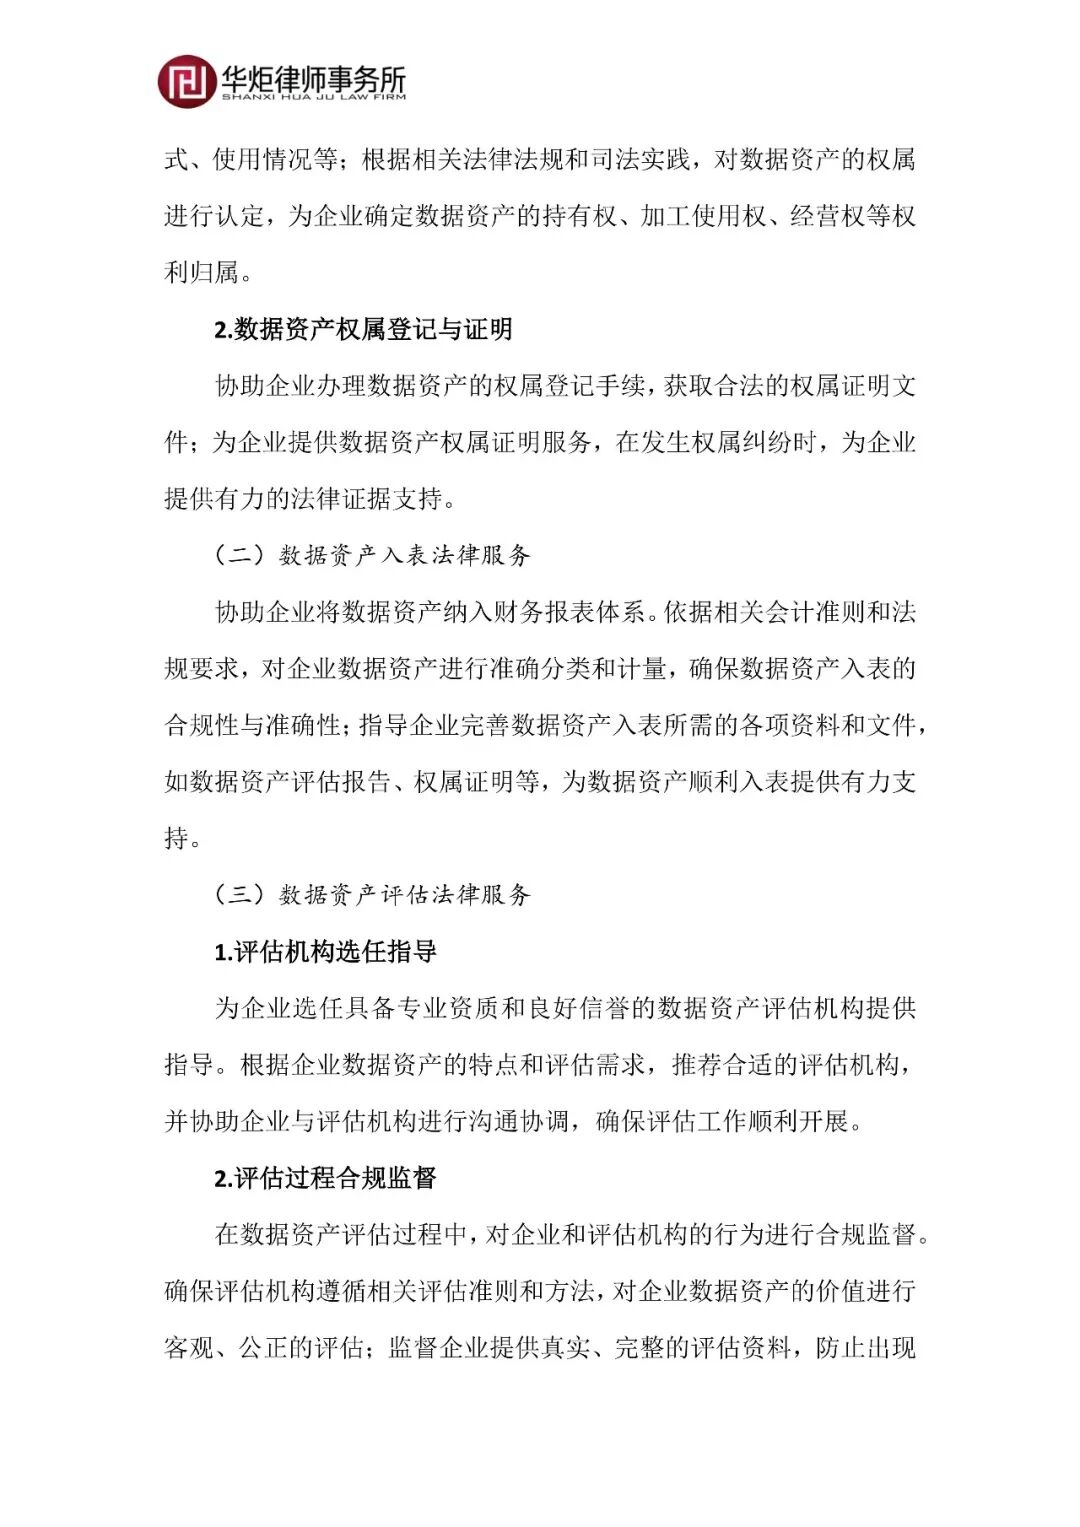
左右滑动,查看华炬数小合服务目录
*本微信文章仅为交流目的
不代表华炬律师事务所的法律意见